
2026年10月8日に、NISTの必要サンプル数、statsmodelsの検出力計算、ASA声明を再読しました。最小検出効果、alpha/beta、分散、割付、主要指標、停止条件を事前に記録し、サンプル数や有意差を改善効果・収益の保証とは扱いません。
購入率がAでは2.0%、Bでは2.5%だったとします。Bを採用してよいでしょうか。判断には、何人中の何件か、どう割り付けたか、どれくらいの差なら採用する価値があるかが必要です。
この記事では、購入の有無を利用者単位で数えるA/Bテストを例に、統計の読み方を説明します。数値例はすべて学習用の架空データで、実際の施策成果ではありません。
30秒で要点
- p値は「改善が本物である確率」ではない。検定の前提と一緒に読む。
- 差の大きさと信頼区間を併記する。同じ購入率差でも人数によって不確実性は変わる。
- 指標、割付単位、必要人数、終了条件を開始前に決める。途中の品質監視と効果の最終判定を分ける。
比較できる二つの群を作る
A/Bテストは、対象者をランダムにAとBへ割り付け、決めた指標を比較する実験です。同じ期間にランダム割付を行うことで、もともとの購買意欲などが一方へ偏るのを抑えます。前月と今月を単純に比べる場合とは、因果関係を判断するための条件が異なります。
ただし、ランダム割付でも有限の標本では偶然の不均衡が残ります。AとBで計測漏れが違う、同じ人が両方を見る、他の利用者の行動が影響する、といった問題も別に確認しなければなりません。
例えば利用者単位で割り付けたのに、同じ人の10回の訪問を独立した10人として扱うと、見かけの標本数を増やしてしまいます。以下の計算例では、各人が一方の群にだけ入り、定めた観測期間内の購入の有無を一度だけ数え、利用者間が独立と仮定します。企業や店舗ごとの割付では、そのまとまりを考慮した分析が必要です。Microsoftの実験設計資料は、割付IDの安定性や群間の影響を論点として挙げています。
効果量は「何ポイント違うか」から読む
2.0%から2.5%への差には、二つの表し方があります。
表が収まらない場合は、横にスクロールできます
| 表現 | 計算 | 意味 |
|---|---|---|
| 絶対差 | 2.5% − 2.0% = 0.5ポイント | 購入率そのものの差 |
| 相対差 | (2.5 − 2.0) ÷ 2.0 = 25% | Aの購入率を基準にした増加割合 |
「25%改善」だけでは元の率が分かりません。AとBの人数・購入件数、両群の率、絶対差を先に書き、必要なら相対差を添えると誤解を減らせます。
事業上の判断では、購入率だけでなく一件あたりの利益、値引き費用、返品やエラーの増加も考えます。小さい差でも費用を上回る場合があり、大きく見える差でも損失が伴う場合があります。
p値は、仮説を置いた後の確率
「母集団の購入率はAとBで同じ」を帰無仮説とします。p値は、この仮説と統計モデルが成り立つと仮定して、観測値以上に極端な検定統計量が出る確率です。両側検定なら、改善側だけでなく悪化側のずれも考えます。
ここで条件の向きを逆にしないでください。p値0.03は「差がない確率3%」でも「偶然だけが原因である確率3%」でもありません。米国統計学会の声明も、この二つの解釈を否定し、有意性だけで事業判断をしないよう求めています。
有意水準は、帰無仮説が正しい場合に誤って棄却する割合を制御するため、事前に置く基準です。例えば適切に設計した検定で5%を選ぶのであって、結果を見て都合のよい閾値へ変えるものではありません。p値がその基準未満なら「統計的に有意」と呼びますが、効果の大きさや実験の品質を保証する言葉ではありません。
信頼区間で、残っている不確実性を見る
次の二つは別々の架空実験です。どちらも購入率はAが2.0%、Bが2.5%ですが、人数が違います。
表が収まらない場合は、横にスクロールできます
| 架空例 | Aの購入件数/人数 | Bの購入件数/人数 | 差の95%信頼区間 | 両側p値 |
|---|---|---|---|---|
| 少人数 | 20/1,000 | 25/1,000 | −0.80〜+1.80ポイント | 約0.451 |
| 多人数 | 200/10,000 | 250/10,000 | +0.09〜+0.91ポイント | 約0.017 |
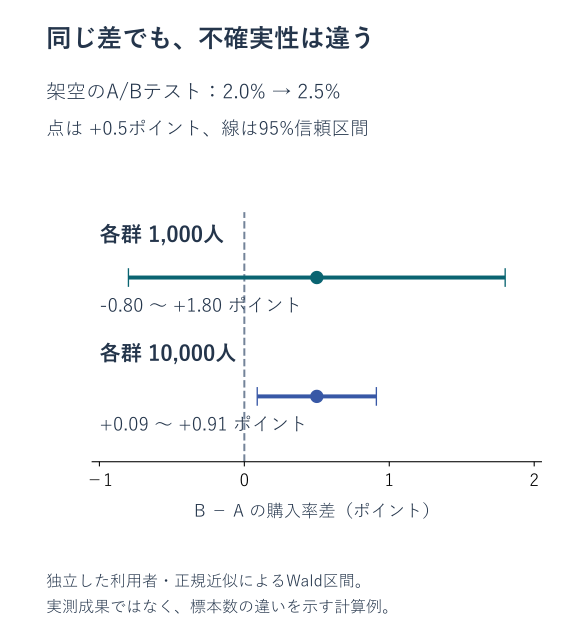
この表は、独立した二つの比率について、信頼区間を非プールのWald法、p値をプールした分散による両側z検定で計算しました。statsmodelsの比率z検定と独立した式で計算を照合しています。正規近似の説明例であり、購入件数が少ない場合や率が端に近い場合に一律推奨する方法ではありません。区間と検定で使う近似も異なります。
95%信頼区間の「95%」は、前提を満たす標本抽出と同じ計算を繰り返すと、作られた区間の約95%が真の差を含む、という手順の性質です。得られた一つの区間に真の差が95%の確率で入るという意味ではありません。NISTの信頼区間の説明でも、この区別を確認できます。
少人数の例は改善も悪化も含む幅です。「効果がない」ではなく、判断に必要な精度が足りない可能性があります。多人数の例でも、採用に必要な最小差を下回る値が区間に含まれていれば、実務上の価値はまだ不確かです。
人数と終了条件を先に決める
検出力は、特定の差が本当にあるときに、設定した検定でそれを検出できる確率です。小さな差まで検出したいほど、一般に多くの標本が必要になります。「何人いれば十分か」は、次の項目を揃えて計算します。
- 対象者と割付単位、主要指標の分子・分母、購入を数える観測期間。
- 過去データ等から置く基準率と、検出したい最小の絶対差。
- 有意水準、検出力、片側・両側、AとBへの配分比。
- 必要人数と実施期間、重大な不具合時の停止条件。
通常の固定期間のp値を毎日計算し、有意になった日に成功として止めると、当初の誤検出率を保てません。早期判定が必要なら逐次検定など、繰り返しの判定を扱う設計を始める前に選びます。複数の案や主要指標を試す場合も、どの比較を一組として扱い、どう多重性を調整するかを計画します。
一方、エラー、計測欠落、想定した割付比からの異常なずれは途中でも監視します。Microsoftの実験中の確認事項も、品質の監視と、繰り返し測定への統計的な対応を区別しています。
採用判断には、結果と限界を一緒に残す
報告では「有意でした」で終わらず、割付と計測に問題がなかったか、各群の件数、差と区間、主要指標以外の悪化、費用を並べます。採用・再検証・見送りの理由が、最初に決めた判断基準とつながっているかを確かめます。
ベイズ法を使う場合は、事前分布とデータから事後分布を求め、優越確率や損失を評価できます。ただし購入率二つだけから「Bが優れる確率」を出すことはできません。人数、モデル、事前分布、停止と採用の基準を明示する必要があります。
最初の実験では、検証したい差を一文にし、指標と終了条件を一枚に書くところから始めます。統計量はその計画を評価する道具です。計画や計測の欠陥を、小さいp値で埋め合わせることはできません。