
20人に案内して8人が購入した。観測された購入率は40%ですが、同じ条件の利用者がもっと来たときの購入率まで、40%に決まったわけではありません。
ベイズ統計学は、未知の値についてデータを見る前に置く分布と、データが生じるモデルを組み合わせ、データを見た後の分布へ更新する方法です。その分布は、採用したモデルと事前分布に条件付いた答えです。方法の名前だけで正確さや因果関係が保証されるわけではありません。
30秒で要点
- 事前分布は未知の値への仮定、尤度はデータが生じる仕組み、事後分布は更新後の不確実性です。
- 同じデータでも事前分布によって答えが変わるため、感度を確認します。
- 信用区間、将来の予測、施策の因果効果は、それぞれ違う問いです。
- 採用判断には確率に加え、差の大きさ、費用、悪化したときの損失が必要です。
事前・尤度・事後は、何についての数字か
未知の購入率をpとし、同じ条件の各利用者が独立に購入するかしないかを観測する、という単純なモデルを考えます。一定期間の購入有無を1人1件で数え、全員が同じpを持つと仮定します。
表が収まらない場合は、横にスクロールできます
| 要素 | この例で表すもの |
|---|---|
| 事前分布 | データを見る前に、pがどの範囲にありそうかを置く分布 |
| 尤度(ゆうど) | pをある値と仮定したとき、今回のような購入数が生じる仕組み |
| 事後分布 | 観測した購入数と事前分布から更新した、pの分布 |
ベイズの定理は、事後分布 ∝ 尤度 × 事前分布という関係を与えます。「∝」は比例するという意味で、最後に分布全体の確率が1になるように調整します。
20人中8人というデータを固定すると、二項モデルの尤度はpに関して p^8 × (1−p)^12 に比例します。これは異なるpが観測データとどれくらい整合するかを比べる関数であり、尤度だけを「pがその値である確率」と読むことはできません。
20人中8人の購入を、実際に更新する
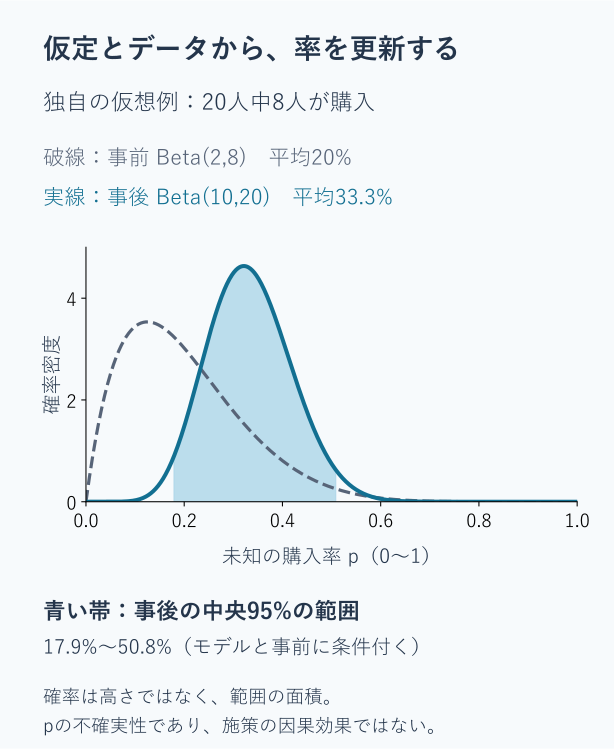
以下は実績ではなく、計算を追うための独自の仮想例です。データを見る前にpへ Beta(2,8) という分布を置きます。ベータ分布は0から1までの率を表せる分布で、二つの正の値a、bで形が変わり、平均はa/(a+b)です。この事前の平均は2/(2+8)=20%です。
二項モデルでs人が購入し、f人が購入しなかったとき、Beta(a,b)は Beta(a+s,b+f) へ更新できます。NISTのベイズ教材が説明する、この組み合わせを使っています。
今回のs=8、f=12を加えると、事後分布はBeta(10,20)です。
表が収まらない場合は、横にスクロールできます
| 項目 | 計算・値 |
|---|---|
| 観測された購入率 | 8/20=40% |
| 事前平均 | 2/10=20% |
| 事後平均 | 10/30=約33.3% |
| 事後の95%信用区間 | 約17.9%〜50.8% |
| pが30%を超える事後確率 | 約63.6% |
事後平均は観測率と同じにはなりません。ここでは事前とデータの両方が反映されています。Beta(2,8)の2と8は仮定を表す値で、実際に過去10人を観測したという主張ではありません。また、この分布がどの事業にも適切という推奨でもありません。
事前を変えたら、判断はどれくらい変わるか
同じ8/20に、別の事前 Beta(1,1) を置くと、事後はBeta(9,13)になります。この事前はpの0〜1で一様ですが、「一切の仮定がない」という意味ではありません。
表が収まらない場合は、横にスクロールできます
| 同じデータに使う事前 | 事後平均 | 中央95%信用区間 | pが30%を超える確率 |
|---|---|---|---|
| Beta(2,8) | 約33.3% | 約17.9%〜50.8% | 約63.6% |
| Beta(1,1) | 約40.9% | 約21.8%〜61.6% | 約85.2% |
「30%を上回りそうか」という読み方まで変わります。都合のよい事前を選ぶための比較ではなく、妥当と考える仮定の範囲で結論が安定するかを見る感度分析です。事前に使った過去データが、今の利用者や価格、計測期間に合うかも確認します。
数値はベータ分布の累積確率から計算し、整数パラメータの場合に使える二項確率の和と別実装の区間探索でも照合しています。計算精度が高くても、仮定の妥当性が確認できたことにはなりません。
信用区間と信頼区間、予測を混ぜない
この例の95%信用区間は、指定したモデル・事前・観測データの下で、pの事後確率の95%が入る範囲です。中央区間として両端に2.5%ずつ残す方法を使いました。他の区間の作り方なら端点も変わります。
頻度論の95%信頼区間は、同じ手順で標本を取り直して区間を作ったとき、固定した真の値を覆う割合が95%になるという性質です。NISTの信頼区間の説明も、この長期的な性質を区別しています。頻度論でも効果量と不確実性を評価できます。ベイズだけがそれをできるわけではありません。
さらに、pの区間と「次の10人のうち何人が買うか」は別です。後者にはpの不確実性に加え、同じpでも購入人数がばらつくことが入ります。この二つを合わせた事後予測分布を使います。今回のモデルで次の10人の平均購入人数は10×10/30=約3.33人ですが、実際の人数は整数であり、毎回3人か4人になるという意味ではありません。
A/Bテストでは、確率から採用条件へ進む
AとBの購入率に分布を置けば、差 pB−pA の分布や、実務上必要な差を超える確率を考えられます。ただし、連続分布だけを置いたモデルでは「差がちょうどゼロ」の確率は0です。「効果なし確率を50%にしたい」と言うだけでは事前分布を定めたことになりません。実務上無視できる差の範囲を定めるのか、ゼロに確率の重みを置く別のモデルを使うのかを区別します。
また、Bが少し良さそうでも、導入費用や問い合わせの増加で採用価値がなくなるかもしれません。Stanの意思決定分析は、行動、結果、効用や損失を定め、予測に基づいて期待値を評価する流れを示しています。
途中のデータで分布を更新することと、いつでも無条件に採用を決めてよいことも別です。事前分布、見直す時点、採用・継続・停止の規則を決め、必要なら想定状況のシミュレーションで誤採用や損失を調べます。事後確率の閾値を使うだけで、頻度論の「誤判定率5%」が自動的に保証されるわけではありません。
そして、購入者の構成が違う二群を比べただけでは、ベイズで計算しても施策の因果効果とは限りません。Pearlの因果推論の論文が整理する通り、観測の確率と介入の効果には別の仮定が必要です。因果推論入門や実験計画法で比較の条件を確かめます。
モデルの点検と、計算の点検を分ける
ベイズ回帰では係数を分布として扱い、階層モデルでは店舗などに共通する情報と個別の違いを表せます。複雑な予測でも、出力された区間だけを見る前に、次の順で点検します。
- 事前から想像する結果:事前とモデルからデータを生成したら、現実には考えにくい値ばかりにならないか。
- 観測とのずれ:更新後のモデルで生成したデータが、観測されたばらつきや偏りを表せるか。
- 仮定への感度:別の妥当な事前やモデルでも、重要な判断が変わらないか。
- 数値近似の状態:近似計算を使った場合、その計算が安定しているか。
最初の二つはStanの事前・事後予測チェックで扱われる方法です。観測を再現できても、因果関係やモデルの正しさの証明ではありません。
今回のベータ分布の例は直接計算でき、MCMCは不要です。より複雑なモデルでは、MCMC(マルコフ連鎖モンテカルロ法)で分布を標本として近似することがあります。その場合はStanの診断ガイドにある、複数の計算系列の一致、有効サンプル数、発散、モンテカルロ誤差などを確認します。数値近似が良好なことと、データ生成のモデルが適切なことは別の確認です。
最初の報告では「何の値を推定したか」「どの事前とモデルか」「データは何件か」「区間と感度はどうか」「どの損失を避けて判断するか」を並べてください。統計の判断ガイドから問いを定め、A/Bテストの記事で比較と区間の読み方を確かめると、確率の数字を実務の判断へつなげやすくなります。