
広告費の多い月ほど売上が高い。その関係を一本の式で表すのが、線形回帰の使いどころの一つです。しかし「広告費が多い月の売上」と「広告費を増やしたために増えた売上」は、同じ問いではありません。
ここでは係数の解釈、予測の不確実性、モデルを使う前の確認を、8件の架空データで説明します。例の当てはまりは実企業の成果や将来の精度を示すものではありません。
30秒で要点
- 係数はモデル上の関係を表す。観測データの回帰だけで施策の因果効果とは言えない。
- 平均応答の信頼区間と、新しい一件の予測区間を使い分ける。
- R²だけで選ばず、残差、利用時点で使える情報、未知データでの誤差を確認する。
単回帰と重回帰は何を表すか
説明したい値を目的変数、その手掛かりを説明変数と呼びます。単回帰は説明変数が一つ、重回帰は複数のモデルです。
単回帰:y = 切片 + 係数 × x + 誤差
重回帰:y = 切片 + 係数1 × x1 + 係数2 × x2 + … + 誤差
例えば売上を広告費と来店客数で説明する重回帰なら、広告費の係数は、モデル上で来店客数を一定にしたときの売上との関係です。変数を追加すると係数が変わることもあります。「来店客数が広告の結果として増える」場合には、それを一定にすることが知りたい因果効果に合うのかも別に検討します。
通常の最小二乗法(OLS)は、観測値とモデルの予測値の差である残差について、その二乗の合計を最小にします。式と単回帰の係数計算はNISTの最小二乗法の解説で確認できます。
8件の架空データから、係数を読む
次は計算を追うための架空の広告費と売上です。両方の単位は万円です。
表が収まらない場合は、横にスクロールできます
| 観測番号 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| 広告費 | 5 | 7 | 9 | 4 | 6 | 8 | 10 | 3 |
| 売上 | 52 | 57 | 63 | 48 | 55 | 60 | 65 | 45 |
切片を含む単回帰の推定式は、丸めると 売上 = 36.976 + 2.869 × 広告費 です。広告費が1万円違うと、モデル上の平均売上は約2.869万円違う関係になっています。
切片は広告費ゼロのときのモデル値ですが、データにある広告費は3〜10万円です。ゼロのときの実売上が約36.976万円だと確認されたわけではありません。30万円など観測範囲外の予測も、直線のまま続く保証がない外挿です。
この例のR²は約0.994です。切片のあるOLSでは、R²は学習データの全変動に対し残差の変動がどれだけ小さいかを示します。「売上の99.4%が広告によって生まれた」「将来も99.4%当たる」という意味ではありません。
同じ予測値でも、二種類の区間がある
広告費7万円のモデル値は約57.06万円です。通常の線形モデルの前提の下で計算すると、次の違いが出ます。
表が収まらない場合は、横にスクロールできます
| 知りたい対象 | 95%の区間 | 含める不確実性 |
|---|---|---|
| 広告費7万円という条件での平均売上 | 約56.53〜57.59万円 | 推定した平均の不確実性 |
| 同じ条件の新しい一件の売上 | 約55.50〜58.62万円 | 平均の不確実性と、新しい観測のばらつき |
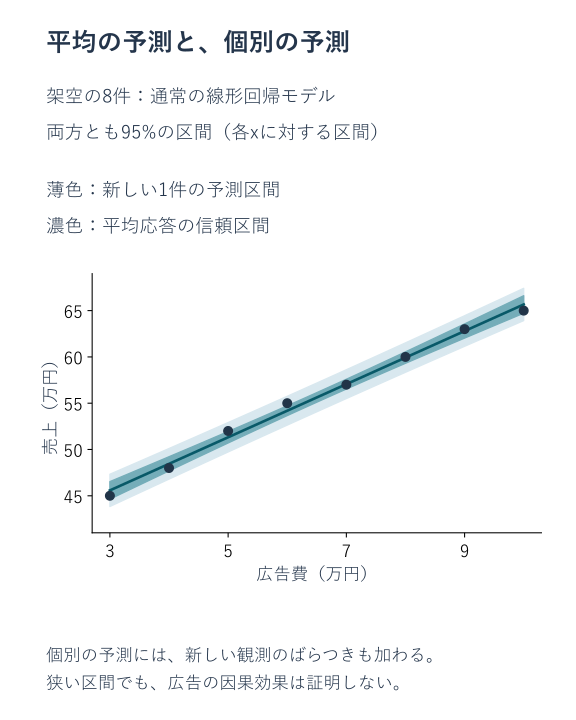
これらは、平均関係が直線で、誤差が独立・等分散・正規分布に従うという通常のモデルに基づくt区間です。架空の8件でその前提が証明されたわけではありません。傾きの95%信頼区間も約2.643〜3.095と計算できますが、交絡による偏りを含めた「因果効果の範囲」ではありません。
信頼区間の95%は、前提下で同じ手順を反復したときの被覆率です。固定した真値が得られた区間へ95%の確率で入るという説明は避けます。NISTの区間解釈と、平均・新規観測の両方を返すstatsmodelsの予測APIを参照してください。
例を再計算するPythonコード
NumPyとstatsmodelsを使う一つの完結した例です。学習時と予測時で、切片列を含む列の順序を揃えています。
import numpy as np
import statsmodels.api as sm

# 学習用の架空データ。実測した広告効果ではない。
ad = np.array([5, 7, 9, 4, 6, 8, 10, 3], dtype=float)
sales = np.array([52, 57, 63, 48, 55, 60, 65, 45], dtype=float)
design = sm.add_constant(ad)  # 列の順番は [切片, 広告費]
result = sm.OLS(sales, design).fit()

print("切片、傾き:", result.params)
print("R²:", result.rsquared)
print("係数の95%信頼区間:", result.conf_int(alpha=0.05))

new_design = np.array([[1.0, 7.0]])
prediction = result.get_prediction(new_design).summary_frame(alpha=0.05)
print(prediction[["mean", "mean_ci_lower", "mean_ci_upper",
"obs_ci_lower", "obs_ci_upper"]])mean_ci_*が平均応答、obs_ci_*が新規観測の区間です。このコードは計算の説明用なので、8件全てに当てはめています。未知データでの性能評価は実施していません。
使う前に、残差とデータの作られ方を確かめる
直線を計算できることと、係数や区間が目的に合うことは別です。NISTのモデルの前提とデータを描いて確認する手順を出発点に、次を確認します。
表が収まらない場合は、横にスクロールできます
| 観点 | 具体的な確認 | 問題があるときの考え方 |
|---|---|---|
| 平均関係の形 | 予測値に対する残差が曲線を描かないか | 変数の変換や相互作用を検討する |
| 誤差の分散 | 大きい売上ほど残差の幅が広がらないか | 変換、分散のモデル化、目的に応じた頑健標準誤差を検討する |
| 独立性 | 同じ店舗の反復記録や時系列ではないか | 店舗内のまとまり、時間相関を扱うモデル・推論を選ぶ |
| 外れ値と影響の強い点 | 入力誤りか、別の状況を表す正しい値か | 理由を確認し、除外前後を比べる。都合だけで消さない |
| 誤差分布 | 小標本の通常区間に無理がないか | Q-Q図等を補助に、分布と設計に合う推論を選ぶ |
誤差が説明変数を条件として平均ゼロであるという条件も重要です。例えば季節需要を見落とし、需要が高い月に広告を多く出していれば、広告係数には需要との関連も混ざり得ます。残差図や頑健標準誤差だけで、この因果上の問題は解消しません。
説明変数を増やすときの注意
広告費合計と媒体別広告費のように、変数の関係が強すぎると係数が不安定になることがあります。完全な線形関係なら係数を一意に決められない場合もあります。多重共線性はVIFなども使って確認できますが、単一の閾値だけで、業務上必要な変数を機械的に消さないようにします。
Ridgeは係数の大きさへ罰則を加え、Lassoは係数をゼロにする形の変数選択にも使われます。scikit-learnの線形モデル資料が説明するように、正則化は予測の安定化の選択肢です。ただし因果関係を識別する仕組みではなく、通常のOLSの区間をそのまま付ければよいわけでもありません。
予測が目的なら、評価用データを先に分け、標準化や変数選択を学習側だけで行います。将来の売上を予測するなら時間順、未経験の店舗へ使うなら店舗単位など、利用場面に合う分割が必要です。評価データの情報がモデル作成に混ざる問題は、scikit-learnのデータ漏洩の説明で確認できます。
価格弾力性を読むときも、予測と介入を分ける
価格と数量が正のとき、log(数量) = a + b × log(価格)というモデルを考えられます。bはモデル上の局所的な弾力性です。仮にb = −1.2なら、価格1%増に対する数量の変化は近似的に−1.2%、有限変化の式では(1.01^-1.2 − 1) × 100で約−1.187%です。
これは仮定したモデルの計算であり、値上げすれば現実にその分だけ需要が減ると確認した結果ではありません。競合価格、季節、需要に応じた値付けを考慮せず、観測係数だけで値上げ効果を決めることはできません。
また、価格×数量は売上です。単位原価を一定と仮定する簡単な粗利の計算は、(価格 − 単位原価) × 数量となります。価格を判断するには原価や販売量の条件を別に置き、売上と利益を混同しないことが必要です。
まずは「未知の値を予測したいのか」「変数間の関連を記述したいのか」「施策を変えた効果を知りたいのか」を決めます。最初の二つで回帰が役立っても、三つ目には追加の実験設計や因果推論が必要になります。