
2026年10月8日に、NIST AI RMF Coreとscikit-learnのmodel evaluationを再読しました。評価は利用環境に近い条件で、テストセット、指標、不確実性、人の監督、運用コストを記録します。accuracyだけでなくconfusion matrixやbalanced accuracyなど、目的とクラス分布に合う指標を選びます。この記事の3事例の企業設定・件数・時間・費用は仮想値で、改善率や正解率を実績、ROI、導入効果へ読み替えません。
AIプロジェクトの成功事例をどう読むか:3業務の仮想例で検証する
「作業時間を70%削減」「年間500万円の効果」という事例を見ても、それだけでは自社に導入する判断はできません。何件の仕事を、どの品質まで仕上げ、確認や手戻りを誰が担ったかで数字の意味が変わるからです。
ここでは製造業の品質検査、ECの問い合わせ対応、マーケティング分析を取り上げます。3事例の企業設定・件数・時間・費用は、進め方を考えるための仮想例です。First byteや実在企業の導入実績ではありません。 実績記事を評価するときにも使える、比較条件と検証の方法を示します。
30秒で要点
- 成功事例は、改善率に加えて対象、比較方法、品質、総費用、運用期間を読みます。
- 生成や分類だけが速くても、確認・修正・例外処理を含む仕事全体が軽くなるとは限りません。
- 品質検査では見逃し、顧客対応では誤回答と引継ぎ、分析では数字の定義と意思決定を別々に確かめます。
- 最初は公開や自動実行を伴わない小さな比較から始め、続ける条件と止める条件を先に置きます。
AIの導入とは、モデルを選ぶことに加え、データ、画面、権限、担当者、運用を組み合わせることです。RAGは、回答時に資料を検索して参照させる仕組みですが、参照した資料の正しさや回答の正確さまで保証しません。基礎は企業向けRAGの設計で補えます。
成功を判断できる事例には、比較の土台がある
事例に大きな数字があっても、導入前は全件、導入後は簡単な案件だけという比較なら、同じ仕事を比べていません。比較期間に注文量や担当者が変わった可能性もあります。
NISTのAI RMFは、試験データと指標を記録し、利用環境に似た条件で評価すること、人の監督や誤りに伴う費用も考えることを挙げています。これは導入効果を保証する規格ではなく、確かめる対象を整理するための枠組みです。表が収まらない場合は、横にスクロールできます
| 事例で確かめる項目 | 読者が知りたいこと |
|---|---|
| 対象と分母 | 全件か、一部の定型業務か。失敗・保留も含むか |
| 比較方法 | 同じ難しさ・資料・受入品質で比べたか |
| 時間 | 人の作業時間か、受付から完了までの経過時間か |
| 品質 | 正解率だけでなく、重大な誤りや見逃しはどうか |
| 費用と運用 | 導入、利用料、確認、保守、障害対応を含むか |
導入前後の差は、AIの因果効果と同じではありません。同時期の比較や、可能な場合の無作為な割当で他の変化を分けます。現場で比較できない条件は、そのまま留保として残します。
製造業:検査を速める前に、見逃しを数える
従業員50名の工場で、検査画像、検査結果、月次レポートが別々に管理されていると仮定します。画像認識、ダッシュボード、レポート作成の三つを同時に自動化すると、問題が起きた場所を見分けにくくなります。
最初の対象は、一つの製品・撮影条件での不良候補の提示に絞ります。学習に使った画像と評価用の画像を分け、同じ製品の連続撮影画像が両方に入らないよう、製造日やロット単位でも分離します。照明、材質、傷の種類が変わる条件は別に確認します。
「正解率95%」だけでは、検査の目的が見えない
次はモデルの実測値ではない、1,000件の仮想検査結果です。不良の有無は、別の確認工程で決めたとします。
表が収まらない場合は、横にスクロールできます
| 正しい判定 | AIが不良候補にする | AIが良品候補にする | 合計 |
|---|---|---|---|
| 不良 | 18 | 2 | 20 |
| 良品 | 32 | 948 | 980 |
| 合計 | 50 | 950 | 1,000 |
正解率は(18+948)/1,000=96.6%です。一方、不良20件のうち2件を見逃しています。不良を拾う割合である再現率は18/20=90%、不良候補50件のうち本当に不良だった割合である適合率は18/50=36%です。定義はscikit-learnの評価指標で確認できます。
全件を良品と答えるだけでも、この仮想データでは正解率98%になります。その方法は不良を一つも拾いません。高い正解率と、必要な検査ができることは違います。
初期運用で50件の候補だけを人が見れば、残り950件にある2件の見逃しを発見できません。まず既存検査を維持した並行評価で、候補外も含めた正解を確かめます。候補の閾値を緩めれば見逃しが減る可能性がある一方、再検査件数が増えるため、両方の負担を記録します。
時間と費用を、別々の収支にする
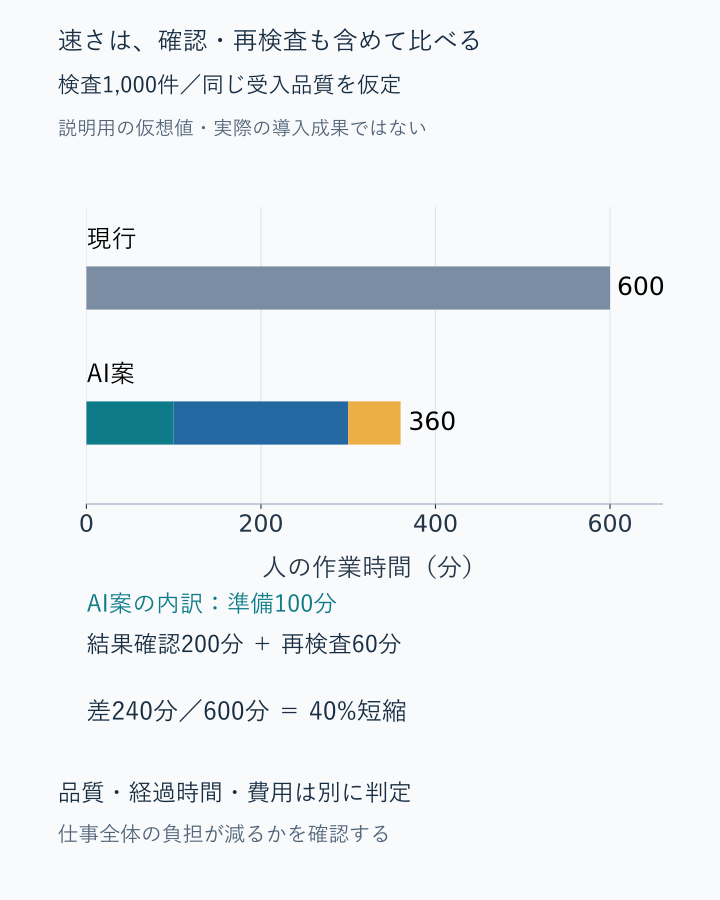
同じ1,000件を同じ受入基準まで仕上げる人の作業時間が、現行600分だったと仮定します。AI案の撮影準備100分、結果確認200分、再検査60分なら合計360分です。差は240分、短縮率は240/600=40%となります。機械の待ち時間を含む経過時間や、検査品質は別に評価します。
費用の例も分けます。月100時間を別業務へ回せると仮定し、評価用の時間単価を3,000円、追加の月額費用を8万円、初期費用を120万円と置くと、初年度の便益換算は360万円、追加費用は216万円、差は144万円です。
これは一定の効果が12か月続く仮定の計算で、現金支出が144万円減るという意味ではありません。残業や外注が減らなければ、給与支出は変わらない場合があります。時間単価に含めた作業を保守費として二重に引かないこと、利用量の増加や不良対応費を落とさないことも必要です。
EC:回答の自動化と、問い合わせの解決を分ける
従業員30名のEC運営で、月1,000件の問い合わせがあると仮定します。配送方法や通常の返品条件は資料で回答できても、個別注文の変更、返金、商品の例外対応には権限と判断が要ります。
最初はAIが承認済みFAQから回答候補を作り、担当者が原資料と照合して送信する形にします。参照資料には対象商品、適用日、責任者を持たせます。資料が見つからない、矛盾する、本人確認が要る案件は保留し、人へ渡します。RAGの導入と、注文変更の実行権限は別の判断です。
仮に1,000件のうち定型FAQが600件、そのうち450件が同じ解決基準まで完了したなら、定型FAQ内では75%、全問い合わせでは45%です。残り550件には担当者の処理が残ります。450件も確認時間がゼロとは限らず、後日の再問い合わせを含めた観測窓を決めてから「解決」と数えます。
表が収まらない場合は、横にスクロールできます
| 観測 | 具体的な定義例 |
|---|---|
| 初回応答まで | 受付時刻から最初の意味ある応答まで。自動受付通知は分ける |
| 解決まで | 受付から、事前に決めた解決条件を満たすまで |
| 人の負担 | 候補確認、調査、修正、引継ぎ、再対応の合計時間 |
| 品質 | 誤回答、根拠不一致、返金等の無権限実行、再問い合わせ |
「2日から4時間へ短縮」は、日を暦時間で数えるなら48時間から4時間で約91.7%です。1営業日を8時間の稼働時間で数えた2日なら16時間から4時間で75%です。受付時間外の扱いを固定せず「80%改善」と書くと、違う時計を混ぜてしまいます。
満足度も回答者だけの平均では偏り得ます。依頼対象数、回答数、質問文、評価尺度を記録し、未回答者を満足した人として扱わないようにします。現場では、引継ぎ先が分かる画面と、担当者が回答を拒否できる余地が必要です。
マーケティング分析:資料が早く出ることと、判断が良くなることは違う
従業員20名の代理店で、複数ツールの数値を集め、月次レポートを作ると仮定します。ここではデータ収集・集計の自動化と、AIによる文章の下書きを分けます。単純な集計なら、決まったルールで動く処理だけで十分な場合もあります。
最初にそろえるのは、日付のタイムゾーン、広告費の通貨・税、成果の定義、重複ID、キャンセルの扱いです。たとえば一つの購入を複数の広告媒体が自分の成果として報告しても、媒体別件数をそのまま足して実売上件数にはできません。元データの総額と集計後の総額を照合します。
仮に現行の収集・集計・文章作成・確認が合計40時間、改善案の収集4時間、集計6時間、文章下書き2時間、照合・修正10時間、打合せ・引継ぎ6時間なら28時間です。短縮は12時間、30%です。下書きだけの速さから全工程の75%削減とは計算しません。
AIの文章には、数値の参照元と集計条件を添えます。「売上が増えたので広告が効いた」という説明が出たら、季節、値引き、在庫、新規顧客の構成など、別の理由を確かめます。レポート完成が早くなったことから、売上やROIの改善まで推定しないでください。
小さな比較を、運用の判断へつなげる
ここまでの三つに共通するのは、AIを入れたことではなく、対象を絞って比較できる状態を作ることです。次の流れは、本記事で提案する進め方です。
- 一つの業務を選び、入力、完成条件、担当者、使ってよいデータを定義する。
- 通常例だけでなく、不鮮明画像、資料欠落、矛盾、例外案件を評価用に残す。
- 同じ案件を比較するときは、先に見た答えによる学習を避けるよう順序や担当を調整する。
- 品質、総作業時間、費用、利用者の負担を並べ、保留を含めて記録する。
- 導入範囲を広げる条件と、元の手順へ戻す条件を決める。
検査なら重大な不良の見逃し、ECなら根拠のない約束や無権限の返金、分析なら金額の不一致を停止候補として事前に定めます。少数例で重大な誤りがゼロでも、将来の発生確率がゼロとは言えません。件数と観測期間を示し、製品・資料・モデル・担当者が変われば再評価します。
最小の一歩は、現在の業務から代表例と困った例を選び、AI案が受入品質まで達するのに誰の時間が何分必要だったかを記録することです。人とAIの協働で総負担を比べる方法や統計的に考える業務判断を使うと、速さだけで判断するのを避けられます。事例の数字は、自社の条件で確かめる問いへ変換して初めて役に立ちます。